
当时大家都笑称llm-rec为taac复活赛,于是我又参加了快手探索者 LLM-Rec 挑战赛。
这次仍然是我个人独立参赛,主要是先充分实践自己的想法,两次大规模的决赛竞赛最终都没有进入复赛。这次主要有我个人的盲目自信的问题,两次比赛以后,都未能进入决赛,如果从获奖角度这显然是不合格的,但是完全从竞赛本身来谈,我认为并不完全错,竞赛不一定要获奖,至少我很有收获,如果再打一次,我有充足的自信可以进入复赛了。
可能进入复赛的分数大约是 1.06,更稳妥的分数是 1.07,而我的最高单次成绩是 1.0282。这个成绩比最早的官方 LoRA 实验 0.7745 高了一些。也一度让我觉得已经摸到了正确答案的边缘。但比赛结束以后再看,1.0282 和 1.07 之间的 0.0418并不是再换一组超参数、再加几百条数据或者多评测几次就能填上的。本次比赛最高进过前50,排名总体而言在50-100之间徘徊。
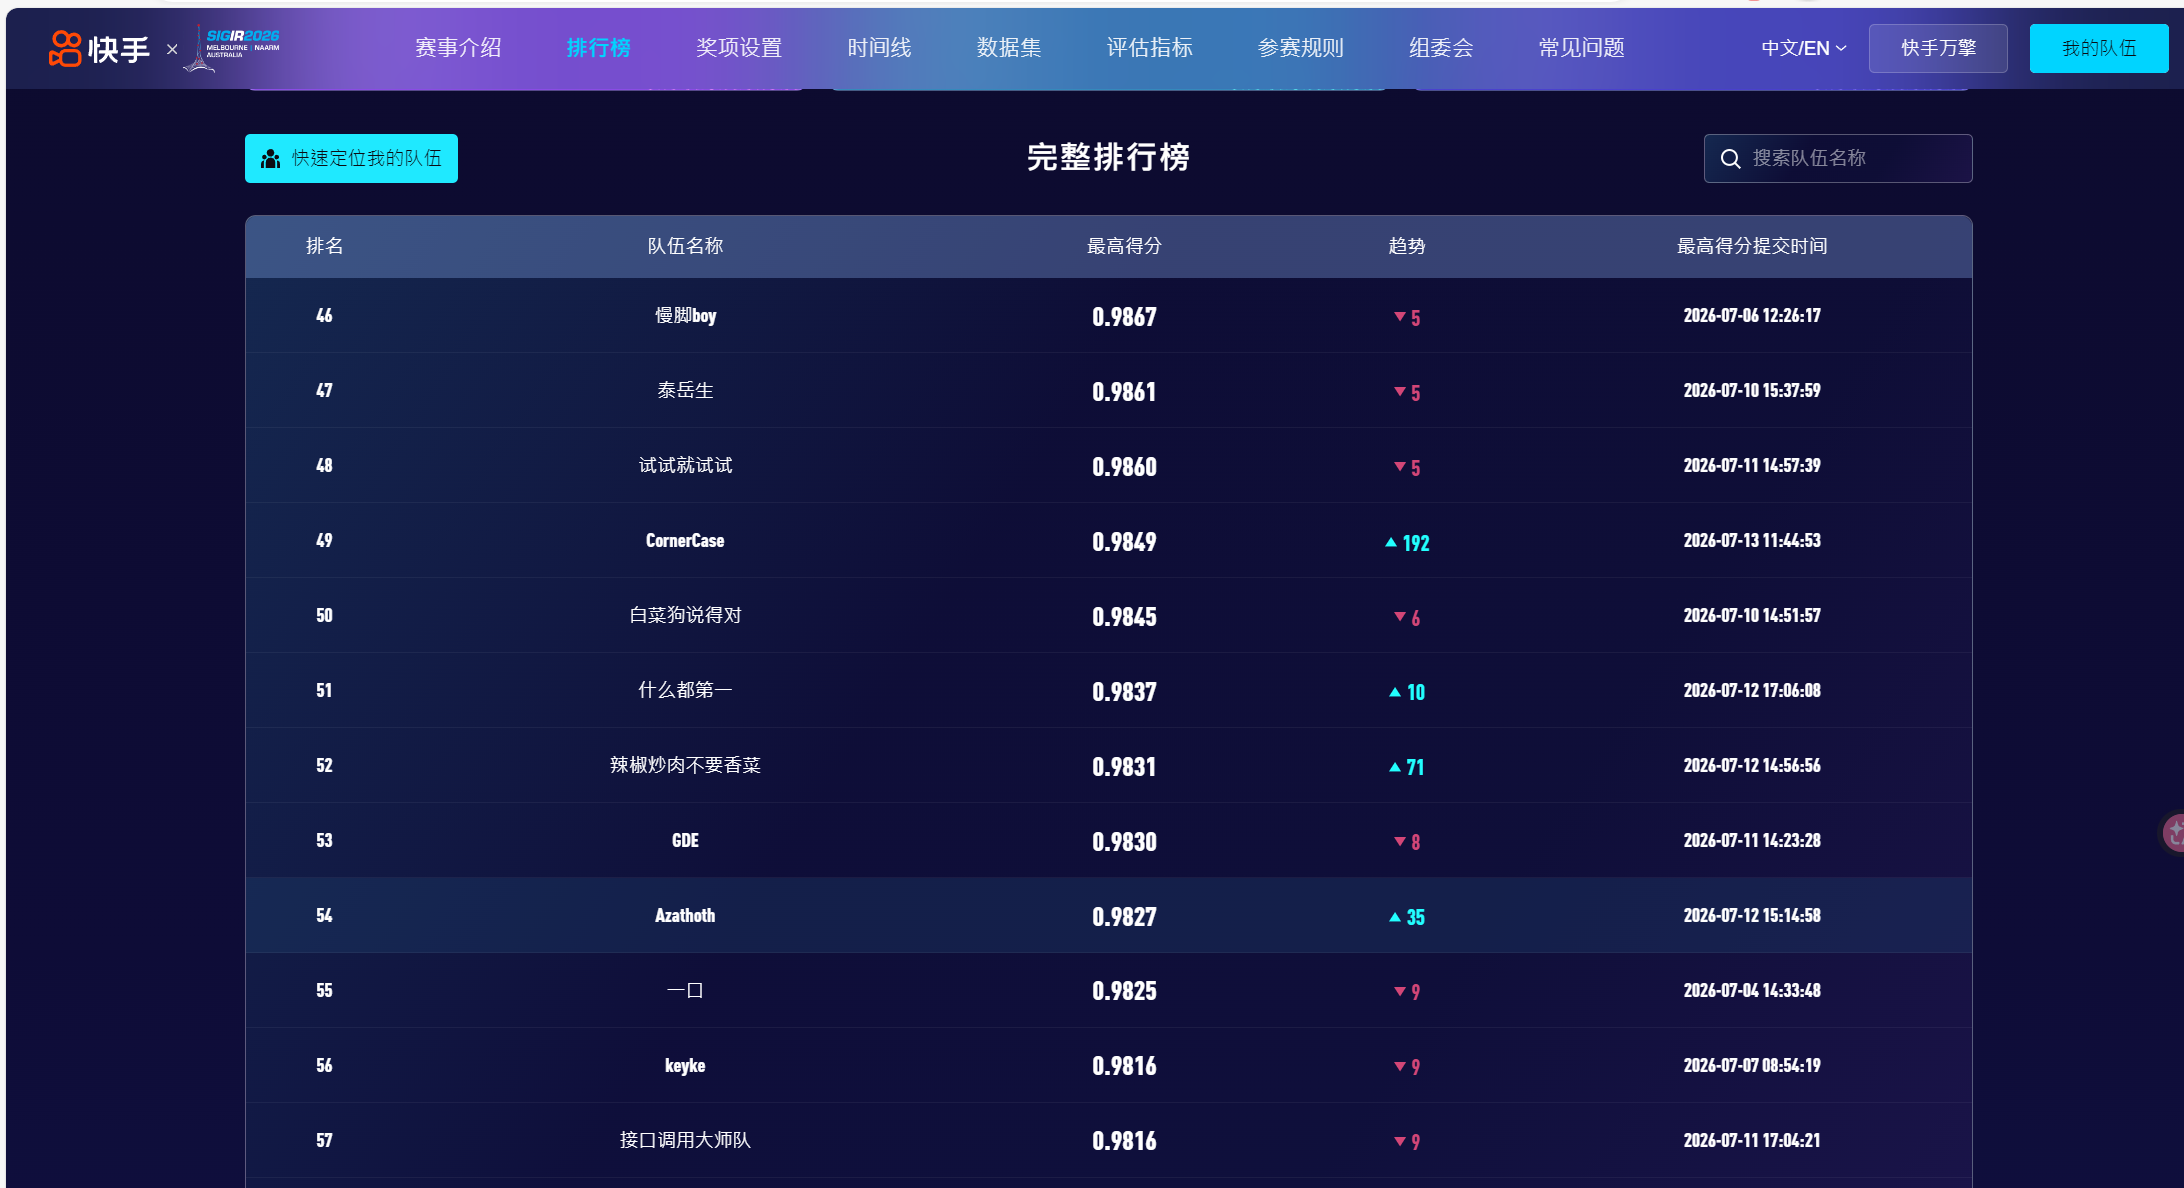
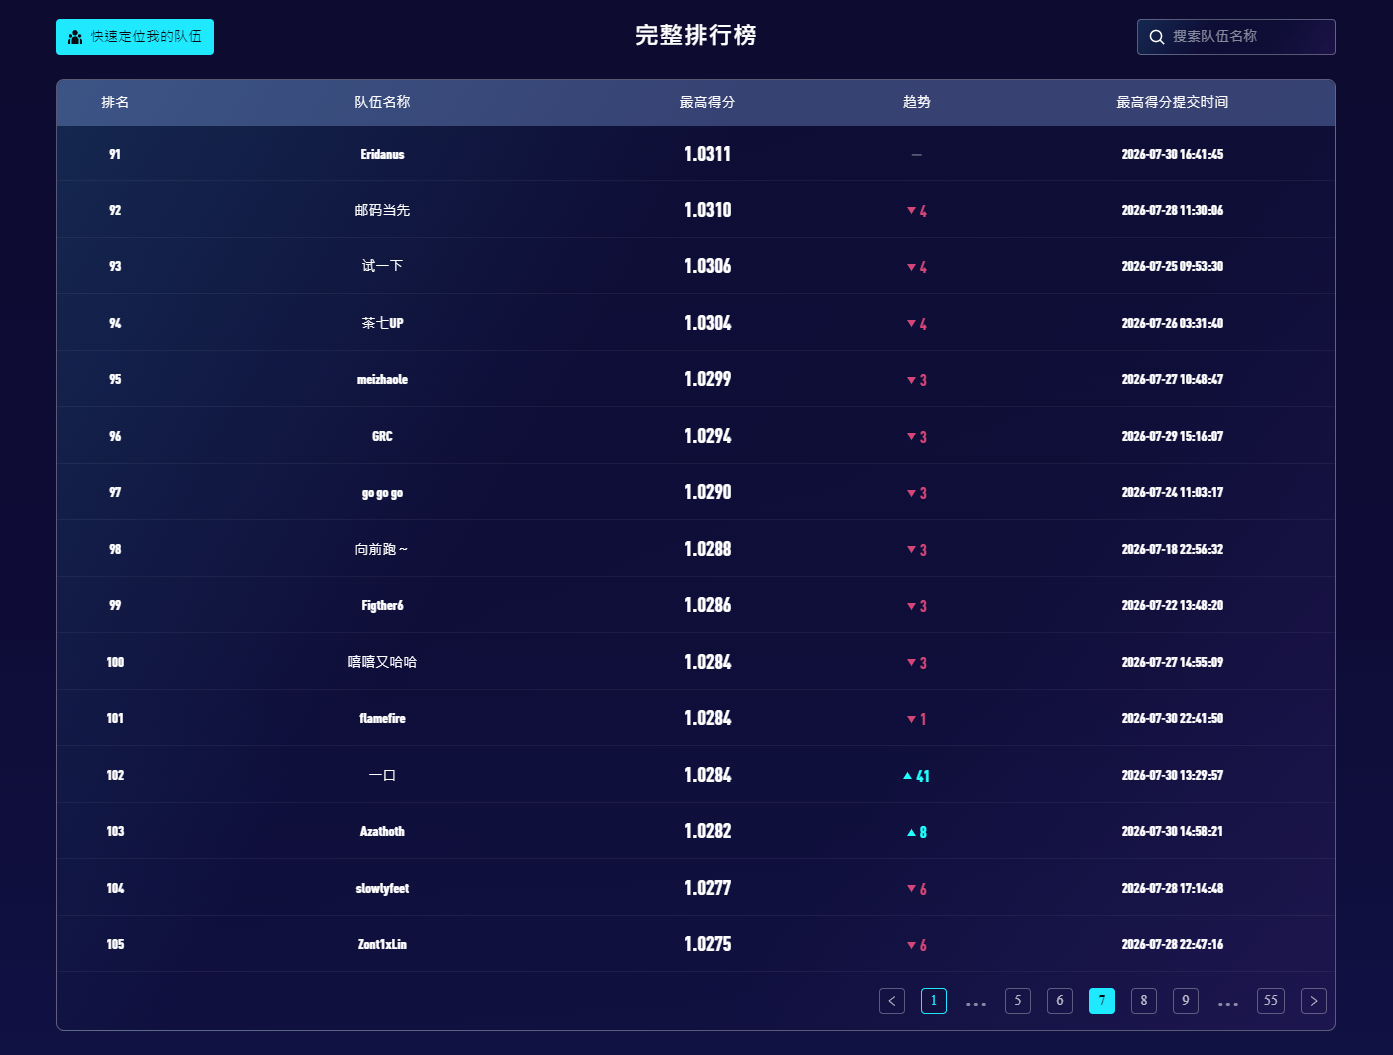
这次比赛我一共维护了 60 多个正式版本,实际训练、checkpoint、复评、Hook 烟测和模型组合实验更多。我们试过 SFT 数据重构、官方 CoT 配额、UserProfile、SID/Tag 语义桥接、极端物料探针、自定义 loss、本地 CV、增量训练和模型拼接。很多方向有道理,少数方向确实涨了分,但大多数实验都没有形成可以持续累计的收益。
最后真正有效的模型 v58,反而不是更大的数据集,也不是更复杂的 loss,而是一个非常保守的同轨迹任务向量投影。
这篇文章不是想把 60 多个版本逐一列出来。我更想回答三个问题:
- 我们真正做对了什么?
- 为什么大量看起来合理的实验反而掉分?
- 为什么最后已经能制造出很多高分分项,却仍然无法让它们同时存在于一个模型里?
这道题到底在评什么
比赛使用一个 0.8B 的 OneReason 模型。推荐系统里的物品并不直接用自然语言名称表示,而是类似下面这样的 SID:
<|video_begin|><s_a_2764><s_b_931><s_c_2403>
模型既要理解自然语言、用户历史和物料语义,又要在最终回答里生成正确的离散 SID。官方总分由八个小项相加:
懂物料
懂用户 1 / 2
懂推荐 Video / Goods / Ad / Live
懂世界
这件事后来成为理解全部实验的关键。它不是一个单目标语言模型微调问题,而是八项能力共享同一个 0.8B 模型、同一套 LoRA 参数的多任务排序问题。
给 Video 加数据,不一定只改变 Video。它还会改变其他任务的隐藏状态、SID 排序和生成路径;给懂物料提高 loss,也可能让懂用户或懂世界退化。比赛中很多所谓的“提升”,本质上只是把分数从一个口袋移动到另一个口袋。
一开始,最大的困难其实不是训练
比赛前期,我们首先遇到的是数据和环境问题。
哈哈哈哈,最大的问题是我没有算力,比赛要微调0.8b的小模型,但是我根本没有可使用的本地算力,持续租卡一个月对我来说还是太奢侈了,所以只能使用白嫖的算力,local训练勉勉强强在百度飞桨云端进行,用的是最便宜的BI-V150S 32GB,我们先优化了一下代码适配一下国产卡的算子,好在我有参加过优化算子类的竞赛,有相关的经验。
但是免费的确实不太好用,官方原始数据接近 17.9GB。Hugging Face 镜像、Xet CAS、SSL 重置、断点续传和不同版本的 huggingface_hub/transformers 轮流出问题。有时下载速度只有几十 KB/s,有时 Xet 直接返回 401,有时一个 800MB 文件下载到 20% 就断开,我甚至下载了好几遍的全量数据不知道为何云端没有成功存下,所以每次想研究一下数据都得等1个多小时下载,然后我选择了干脆放弃本地训练了,选择了用cpu做静态分析,分析模型权重,官方的快手万擎平台虽然不能自己更精细的调整训练代码,但是给的券还是比较慷慨的,尽管我还是不够用。。。。
后来我才逐步把下面这些链路补齐:
- 镜像与直连模式切换;
- 大文件断点续传和失败重试;
- 云端已有数据发现与复用;
- SFT JSONL 构建和数据摘要;
- checkpoint、adapter、模型哈希和提交包管理;
- 本地、飞桨云端和远端 Windows 机器之间的协同分析。
这些工作本身不直接涨分,但没有它们,后面的实验很容易因为数据缺失、版本混淆或上传错误而失去意义。
现在看,我们还是太晚才把工程纪律建立完整。针对算力要求巨大的竞赛我应该早点做好心理准备。要么全靠官方分发的算力,要么提前获取到足够算力,要么只在本地分析这类不耗费算力的工作,折中往往是坏结果。
第一条真正有效的主线:先把 SFT 做对
最早几个版本很快给了我们一些信号。
v1  官方数据初始 LoRA                    0.7745
v2  Rank32 与训练调度调整                 0.8659
v3  混入大量通用/代码数据                 0.8389
v6  全参数训练                            0.7946
v8d 复现 Frinkleko 0.91 清洗 SFT          0.9160
v3 说明通用数据量不是答案。v6 更重要:它的本地验证 loss 更低,官方分数却只有 0.7946。这很早就告诉我们,平台随机切出的 5% validation 和隐藏评测并不等价。可惜我们当时知道这个事实,却没有立刻建立更可靠的测量系统。
v8d 是第一个明确的数据工程正例。它复现了 Frinkleko 公开的清洗 SFT,只用 32,705 行就达到0.9160。这说明任务形状、清洗、去重、thinking/no-thinking 格式和训练轮次,比盲目增加数据更重要。
随后我们开始从官方原始数据构造自己的 SFT。v13 和 v14 使用官方 Caption、Tag、Pid2Sid关系增强懂物料,分数分别只有 0.8108 和 0.8694。v14 的直接 SID 格式明显优于 v13 的长 CoT 双向互译,但它们都没有超过 v8d。
这是第一个很反直觉的结论:
官方发布的真实关系,不自动等于对隐藏评测有效的训练样本。
关系本身可以是真的,格式也可以是对的,但它的目标分布、曝光频次、response 长度和训练时所占梯度预算,仍然可能与隐藏题目不同。
v16:这次比赛最重要的数据正例
真正改变主线的是 v15 和 v16。
v15 把 UserProfile 行为序列重新构造成接近隐藏推荐题形状的样本。v16 则以 v8d 为底座,加入:
4,000 条 UserProfile
3,364 条官方推荐 CoT
1,200 条 item replay
同时使用较轻的正则:
LoRA Dropout = 0.05
Weight Decay = 0.01
v16-v5 epoch3 最终达到 0.9827。相比强正则版本的 0.9590,这不是一个小差异。
v16 告诉我们,高分不是来自某一种数据越多越好,而是来自一个经过筛选的混合:
- v8d 保留语言、指令和各任务的基础能力;
- UserProfile 对齐用户历史到目标 SID 的任务形状;
- 官方 CoT 提供推荐语义和推理路径;
- item replay 保护物料与 SID 输出;
- 轻正则让模型能够走到更尖锐但更有效的多任务状态。
后面的 v28、v51、v54 和最终 v58,实际上都没有离开这条数据主线。
这也是整场比赛少数真正可以称为可累计的主线。
v28:我们看到了高分,却没有立刻理解高分
从 v17 到 v27,我们围绕 Video CoT、Goods/Live 加权、推荐镜像、时间方向、增量训练和不同正则做了很多实验。它们大多在几个分项之间交换能力。
其中 v21-v24 的 Goods/Live 补丁和推荐镜像全部下降;v27 修正了 Goods 时间方向,逻辑上更正确,官方分数却仍然下降。这些结果逐渐提醒我们:字段语义正确,不代表代理目标和隐藏标签一致。
然后出现了 v28。
v28 没有增加新的回答,也没有改变目标 SID。它只重排了 2,726 条 UserProfile prompt 中各目标域段落的位置。结果 epoch3 的懂物料从常见的 0.2146 跳到 0.2453,总分先后测得0.9836 和 0.9890。更奇怪的是,epoch2 和 epoch4 的懂物料都只有 0.2146。
这很容易诱导出一个过强的故事:是不是目标域放在最后就是懂物料的开关?
后来 v38 单独回滚 Video 顺序没有复现这个结论。现在看,v28 更像是特定数据、样本顺序、Packing、scheduler 和 epoch3 优化轨迹共同跨过了一个 SID 排序阈值,而不是某一句question prompt触发了魔法,用以评测的prompt甚至与我们在的评测得分自相关,这让我不知道怎么处理,当然也可能是我过度思考了。
懂物料的历史分数也暴露了明显的离散档位:
0.0920 -> 0.1226 -> 0.1533 -> 0.1840 -> 0.2146 -> 0.2453
相邻档位大约相差 0.0306-0.0307。这不一定意味着每档就是一道题,但至少说明榜单不是连续的。模型内部排序可能已经改善,却因为没有跨过 Top-K 或聚合阈值而显示不变;微小的排序变化也可能突然跳一档。
我们当时看到了结果,却没有足够早地把、输入顺序、优化轨迹和离散阈值分开验证。
我们曾经相信:见过更多 SID,模型就会懂更多物料
这是整场比赛最自然,也最蠢的假设之一。
官方给了 Caption、Tag 和 Pid2Sid。直觉上,只要让模型见过更多 SID、更多 Tag 和更准确的物料描述,它就应该更懂物料;再按原数据比例补一些用户、推荐和世界数据,就可以获得 scaling收益。
为了验证这件事,我们做了 v34-v36 三个极端物料探针。我们接受其他指标下降,使用接近百万行item-only 数据,希望先把懂物料推到很高,再利用多个模型反推隐藏题形状。
结果是:
版本   总分     懂物料   懂用户
v34   0.5061   0.0920   接近 0
v35   0.5510   0.1226   接近 0
v36   0.5897   0.1533   接近 0
这三个模型没有成为我们期待的“高物料专家”。它们只建立了一个较低的物料阶梯,同时几乎摧毁懂用户。懂推荐和懂世界仍然保留一部分分数,说明预训练能力没有完全消失,但微调分布已经严重改变模型的任务路由。
随后我们把 v36 中看起来最有希望的 Tag+Caption 双视图迁回 v28。v37 只加了 55 对高置信粗路径关系,懂物料仍从 0.2453 跌到 0.1840。
v39 和 v40 又构成了一个更干净的三角对照:
- 用 615 条新关系等额替换旧关系,下降;
- 保留旧锚点,再追加同一批新关系,仍然下降;
- 按类似比例把全局数据扩大约 1.5 倍,总分降到
0.8510。
这说明问题并不只是“新增数据挤掉了旧数据”。即使旧数据完整保留,新关系仍然会改变优化轨迹。
我们没有观察到期待的 scaling law。至少在这套 LoRA、固定输出头和隐藏评测下,更多真实 SID关系不是无条件正收益。
为什么真实 SID 数据也会伤害模型
后期对模型结构和训练数据做完整审计后,这件事才变得容易理解。
OneReason-0.8B 是一个 28 层 Qwen3,词表中包含 24,576 个 s_a/s_b/s_c token。我们的主线Rank32 LoRA 只更新每层的:
q / k / v / o
gate / up / down
embedding 和 lm_head 都是冻结的。
这意味着新增 exact SID 监督时,模型不能直接重塑某个 SID 的输入向量或输出行。它只能改变所有任务共享的隐藏状态,让隐藏状态去匹配冻结的 SID 输出向量。
所以“让模型见过更多 SID”并不是在一个独立字典里补知识,而是在移动整个共享表示空间。新关系可能让某批 SID 更容易生成,同时破坏旧 SID、用户任务或自然语言任务已经形成的几何关系。
这并不证明官方 raw 数据没有价值。它证明我们使用它的方式太粗:
数据真实,不代表梯度方向安全;覆盖更多,不代表共享参数能够无损吸收。
行数是一个很有欺骗性的统计量
我们很长时间都在讨论“加 500 条”“删 700 条”“某类占比多少”。后来精确统计 assistant监督 token 后,才发现按行数描述数据配额非常不可靠。
v16 一共 41,269 行。按来源看,它似乎是一个相对克制的混合;但按 assistant token 统计:
| 来源 | 行占比 | assistant token 占比 |
|---|---|---|
| v8d | 79.25% | 71.52% |
| 官方推荐长 CoT | 8.15% | 26.90% |
| UserProfile | 9.69% | 0.78% |
| item replay | 2.91% | 0.80% |
对 v28 再按任务统计,默认 CE 的 response token 大约是:
推荐       80.39%
懂物料      8.80%
懂用户     10.58%
懂世界      0.22%
推荐内部约 654 万 token 是 CoT,最终答案只有约 41 万 token。
换句话说,官方按八项计分,但默认训练目标主要在优化推荐长 CoT。所谓“给懂世界加几百行”,放进 32K Packing 和长 CoT 后,实际梯度预算可能仍然非常小。
我们最终精确复现了平台流程:
41,269 条原始 SFT
5% validation,seed=42
4 个连续预处理 shard
每 1,000 行执行 greedy knapsack
得到 1,488 个 train pack / 81 个 validation pack
batch size=1,gradient accumulation=4
本地 replay 与平台日志的 pack token 均值只差约 0.5%。到这个时候,我们才真正知道一次更新里模型看到了什么。
可惜这个认识来得太晚。前面很多所谓的数据比例实验,其实没有控制监督 token、pack 共现和总优化步,不能被视为干净的配额实验。
自定义 Hook:拥有控制权,不等于知道该怎么控制
比赛前期我就使用了hook,希望获取更多的信息,但是可能因为比赛仓促,万擎平台并未使用我的hook,一度让我觉得是不是平台就不支持自定义。比赛后期,平台开放了自定义 compute_loss。这看起来像一个很大的低垂果实:既然默认 CE 被长 CoT 主导,我们能否降低 CoT 权重,提高最终答案、懂物料和懂世界权重,让八项能力更平衡?但是答案是否定的,我意识到官方已经修复好自定义代码的时候已经太晚了,我们根本没有足够的时间和机会完整的消融完hook对我们的作用究竟是什么,这仍然是我没有提前准备好算力的问题。
v42a-e 先用小数据确认 Hook 确实执行,Packing 下也能取得 item_mask。但第一份正式实验 v43很快暴露了问题:在 GA4 下,我们的 loss 被整体放大约 4 倍,并且错误地按每个 microbatch独立归一。v43 epoch3 只有 0.9081,它不能被解释成一个干净的 item 加权实验。
于是我们又做了 v48a-f 小实验,逐步校准平台语义。最终确认默认 CE 是一个梯度累计组中所有有效 token 的统一 mean。自定义 loss 如果忽略组级分母,即使权重公式看起来正确,也会通过组间标量误差改变完整训练轨迹。
修正以后,v49 的 Video/Ad 轻加权仍只有 0.9301。v57 进一步精确复现 Packing 预算,降低推荐 CoT、提高 final answer、item、user 和 world 权重,最终也没有产生总分正收益。
这条路线不是完全没有信息。v43 某些 checkpoint 的懂用户、Goods、Ad、Live 和懂世界同时提高,而懂物料明显下降;v57 的懂世界最高达到 0.1662,但物料和 Video 回落。它们证明 loss权重确实能移动能力,只是我们仍然没有找到让能力共存的约束。
自定义函数给了我们更强的方向盘,但没有给出正确方向。
本地 CV:我们一直想摆脱盲人摸象
官方评测次数有限,完整训练又昂贵。最理想的状态当然是在本地构造接近隐藏题目的 CV,再用历史十几个模型的官方八项分数反推哪些本地题型真正相关。
我们为此做过:
- shadow item 候选集;
- Caption/Tag 到 SID 的 Top-K 生成;
- teacher-forcing 置信度;
- direct-SID 与 retrieval 探针;
- 13 个历史模型的函数空间比较;
- 远端 CPU 推理和权重模块审计。
这些指标可以发现模型是否彻底坏掉,却不能稳定排序 0.99 附近的候选。v50 使用 v16、v28、v32 的 teacher-forcing 置信度选择替换样本,最后只有 0.9453。v40 的验证 loss 更低,官方分数反而更差。
我们最终明白:
一个没有经过历史模型校准的 proxy,最多是灾难检测器,不是排行榜预言机。
官方推荐评测本身也存在明显波动。同一个 v51 adapter 连续五次结果是:
1.0180 / 0.9895 / 1.0004 / 1.0105 / 1.0142
均值 1.00652,范围 0.0285
五次懂物料都保持 0.2453,波动主要来自 Video,部分轮次 Goods/Ad 也跨档。这意味着单次高分不能直接视为模型期望,但重复评测的波动也不足以填补我们到 1.08 的缺口。
真正需要的不是更多本地指标,而是一个能在 8 到 12 个历史模型上排序官方分项的候选级 CV。由于taac2026的影响,我对本地cv很执着,我用了自己的x_ai工具包想裁开模型看看是哪些权重得分了,很自然的我认为得分的区间肯定集中在高维的某一个确定空间里,但是,这是人为设置的题目,从懂物料的离散化评分我就应该想到不同题目之间的联系可能很弱,不一定在高维空间中是连续的,且整个空间太大了,没有正确的约束,没有正确的条件信息,我们做了很多探针,却始终没有建立这个闭环。
模型拼接:为什么不能把每个模型最强的部分加起来
当我们已经拥有多个各有所长的模型时,一个很自然的想法是:能否把 v16、v28、v43 等模型拼起来,继承它们各自最强的小项?
我们试过的远不止一次平均:
| 版本 | 方法 | 总分 |
|---|---|---|
| v30 | v16/v28 有效 DeltaW 的 50/50 中点 | 0.9637 |
| v44 | checkpoint 阶段差分迁移 | 0.9492 |
| v45 | v16 + v28 完整 LoRA 直和 | 0.4925 |
| v46 | v28 同轨迹上替换 4 层 Q/K | 0.9722 |
| v47 | v28 导入 v16 前 14 层 Q/K | 0.9250 |
这些模型都通过张量恒等式、配置和真实加载验证。失败不是文件损坏,也不是不会计算 LoRA。后期组合统一使用有效更新:
DeltaW = B @ A
真正的问题是,高分端点之间并不存在一条平滑的高分线段。一个 checkpoint 的变化依赖它所在的参数上下文,不能被当作独立技能插件。标准 LoRA 也没有按题型路由能力,Video、物料和用户能力分布在跨层协同状态里,不是某几层 Q/K 可以单独搬走的模块。
v45 尤其有教育意义。两个接近 0.98 的模型完整直和后只剩 0.4925。参数更多、能力来源更多,并不意味着模型能自动选择正确能力。
v51 和 v54:第一次找到可重复的局部方向
模型拼接大多失败,但 v51 提供了一个不同的信号。
v51 没有把两个远处高分模型硬拼在一起。它从 v28 完整主干出发,只注入 10% 的同数据、同基座大学习率 epoch4 差分。它的最高单次是 1.0180,五次均值 1.00652,并且五次懂物料都保持0.2453。
这说明在同一训练轨迹附近,确实存在一条可以提高跨档概率、同时保护物料的小方向。
与此同时,v54 使用 v28 原数据,把学习率调到 1.1e-4 完整重训。它没有创造单次最高分,但三次评测均值 0.99453,形成了一个比较稳定的非 Video 底盘。
到这里,我们第一次拥有两个不同性质的资产:
v54:稳定主干
v51 - v28:有五次官方正证据的局部方向
v58:这次比赛唯一成功的模型组合
v58 的公式并不复杂:
DeltaW_v58 = DeltaW_v54_epoch3
           + 0.122591020054269 * (DeltaW_v51 - DeltaW_v28)
但它与之前拼接的区别非常具体。
v54 相邻 checkpoint 的训练变化,与 v51-v28 方向在 196/196 个 LoRA 模块上内积同号。也就是说,这不是只看全局余弦后随便选的一条方向,而是两条独立训练轨迹逐模块共同支持的方向。
同时,v58 把更新限制在距 v54 大约 1.13% 的小信任域内。它没有试图让两个模型各占一半,而是把 v54 当作完整能力主干,只允许一个经过重复官方结果支持的小修正。
最终最高单次是 1.0282。现有仓库可以完整核验的另外两轮是 1.0234 和 1.0145。后两轮的懂物料都保持 0.2453,非 Video 底盘也相对稳定。
这不是可无限扩大的配方。v59 把同一方向的剂量提高约 45.6%,分数立刻降到 0.9944;v60加入一个参数空间正交的高 Video 残差,也只有 0.9895。
v58 真正证明的是一个很窄的结论(这让我时不时的怀疑,我是不是对的,正确得分答案的参数空间确实积聚在一个狭窄的区域):
共同原始基座
可解释的共同父轨迹
完整稳定主干
重复官方正证据
逐模块方向一致
相对主干的小信任域
这些条件同时成立时,任务向量可能带来净增。它并没有证明“融合模型比训练更强”,更没有证明参数正交就等于功能互补。
我们真正错在哪里
现在回头看,最大的错误不是没有找到某一种神奇数据,也不是 LoRA Rank、Dropout 或 Weight Decay 少调了一组。
第一个错误是,我们太晚才建立测量系统。
早期实验经常同时改变数据簇、格式、epoch、Dropout、WD 或 checkpoint。一个版本上涨或下降以后,我们可以讲出很多故事,却不能确定是哪一个变量造成的。直到后期,我们才开始系统使用数据哈希、构建 manifest、重复评测、预注册停止规则、token/Packing 审计和有效 DeltaW。
第二个错误是,我们长期用行数代替训练预算。
当官方长 CoT 只占 8.15% 的行,却占 26.90% 的 assistant token;当懂世界只占 0.22% 的response token 时,“增加几百条”几乎没有统一含义。我们很早就在调整配额,却很晚才知道自己实际调整了多少梯度。
第三个错误是,我们把公开真实数据和隐藏同分布数据混为一谈。
Caption、Tag、Pid2Sid 都是真的,但隐藏题目的物料集合、模板、候选协议和频次分布并未公开。v13、v14、v34-v40 已经反复说明,真实关系不等于安全增量。我们仍然花了太多时间寻找“再多见一些 SID 就会涨分”的证据。
第四个错误是,我们试图用参数空间解释功能空间。
余弦、范数、模块替换、SVD 和正交残差可以帮助排除结构错误,却不能自动预测八项得分。v58成功不是因为“余弦高”这么简单,而是共同父模型、小剂量、独立轨迹同号和稳定主干同时成立。v59 和 v60 很快证明,这个局部正例不能扩张成通用融合理论。
第五个错误是,我们找到了分项能力,却没有优先研究能力共存。
历史逐项最好分数的和一度超过 1.09,加入外部物料高档后甚至接近 1.12。但这些峰值来自不同数据、checkpoint、loss 和模型。我们总在问如何提高某一项,真正应该更早问的是:
如何提高某一项,同时把另外七项写成不能退化的约束?
标准 SFT 的加权 CE 没有解决这个问题,静态 LoRA 拼接也没有解决。
我们也做对了一些事情
这次比赛并不只是 60 多个负结果。
v8d 到 v16 建立了一条真实有效的 SFT 数据主线;v28 让我们看到输入顺序、Packing 和训练轨迹可以共同改变离散 SID 档位;v48 用低成本实验彻底查清平台 Hook 和 GA4 归一化语义;v51 首次给出同权五评的局部正方向;v54 提供稳定主干;v58 最终把这些证据组合成一个可解释的正结果。
我们还下载并固定了完整官方数据和基座,审计了 tokenizer、SID 词表、LoRA 目标模块、数据来源与监督 token;对关键模型做了重复评测;对失败拼接验证了文件、配置和张量恒等式;也保留了大量负结果,没有在赛后把每次失败都重新解释成“可能只是随机”。
最高分没有达到目标,但这条从 0.7745 到 1.0282 的路径不是一次偶然提交。
如果重新参加一次
如果带着现在的认识重新开始,我会完全改变实验顺序。
第一阶段只建立测量,不追复杂想法:
- 固定官方数据、模型、tokenizer、训练代码 commit 和全部哈希;
- 至少做两次同配置独立训练、两次同权评测,分离训练与评测随机性;
- 第一周就精确复现 split、Packing、sampler、GA 和 scheduler;
- 从一开始记录每类 assistant token、目标 SID 支持和 optimizer step 共现;
- 用 8 到 12 个历史模型校准候选级 CV,不能排序官方结果的指标只做灾难筛查。
第二阶段建立稳健 SFT 主干:
- 从 v8d/v16 这类经过验证的清洗混合出发;
- 每次只改变一个数据簇或一个模板变量;
- 保持 validation 成员、目标 SID 支持、监督 token 和优化步可比;
- 用 token 预算而不是行数控制八任务比例;
- 为每个实验保留同期原样主干作为控制。
第三阶段才改变目标函数。如果平台允许,我会优先尝试:
- 对 SID 使用候选级 contrastive 或 listwise loss,而不是只做单答案 token CE;
- 让
lm_head/embedding获得受控低秩更新,而不是只移动共享隐藏状态; - 使用 PCGrad、梯度投影或约束优化,把物料和推荐锚点写成保护条件;
- 只有 reward 能排序历史模型时,才启动 GRPO/PPO 一类 RL。
最后才做局部模型组合,而且只接受 v58 这一类条件:共同基座、共同父轨迹、重复官方证据、逐模块共识和小信任域。
这次比赛给我的教训
第一,数据量不是数据价值。比赛数据再真实、再大,如果目标分布、监督预算和优化接口不匹配,
它仍然可能是负收益。
第二,validation loss 不是最终目标。它可以告诉我训练有没有坏掉,却不能替代候选级隐藏评测。
第三,多任务比赛最困难的不是制造一个强项,而是让强项共存。看到某个分项上涨时,必须同时检查其他任务付出了什么代价。
第四,局部有效规律不要急着扩张成理论。v58 的小信任域投影有效,v59 和 v60 随即告诉我们,剂量和方向只要稍微离开证据范围,收益就会消失。
这次我最终停在了 1.0282。它没有把我送进复赛,但让我第一次真正理解:在 LLM 推荐后训练里,构造知识只是第一步,更难的是控制这些知识以什么比例、什么路径进入共享参数,并让八种能力在同一个 checkpoint 里同时存在。